neural-trees'i Yazdım. Artık Başkaları Kullanabilir. Ne Yapıyor, Ne Yapmıyor.
Kütüphane bir ders kitabıyla başladı. Ethem Alpaydın'ın Introduction to Machine Learning (Yapay Öğrenme) kitabında karar ağaçları bölümü tam işin ilginçleştiği yerde bitiyor: bölünmeleri tek bir özellik yerine özelliklerin ağırlıklı toplamı olan ağaçlar, bölünmeleri yumuşak olan ağaçlar ve eğitilirken kendi boyutuna kendisi karar veren modeller. Bunların her birini Alpaydın'ın grubu yıllar içinde yayımladı. Hiçbirinin pip install'ı yoktu. Kendi verinizde bir yumuşak karar ağacını scikit-learn'ün CART'ının yanına koymak istiyorsanız kendiniz yazıyordunuz, sonra da çalışmayanın sizin sürümünüz mü yoksa makaledeki mi olduğunu bilmenin bir yolu yoktu.
Ben de yazdım. İlk sürüm nisanda PyPI'a çıktı; şu anki sürüm 0.7.0. Bu yazı, ne işe yaradığının adım adım hesabı ve nerede işe yaramadığının; çünkü okuyanın gerçekten kullanabileceği kısım ikincisi.
Önce bir sınır çizeyim. Aşağıdaki her sayı depodaki bir betikten geliyor ve yeniden çalıştırılabilir. Bir tasarım kararı makalenin değil de benimse, o karar ölçüldü ve ölçümler belgeleme sitesinde duruyor; aleyhime çıkanlar da dahil.
Adım 1. Karar Ağacı Ne Yapar, Yumuşak Olanı Neyi Değiştirir
Bir karar ağacı her seferinde tek bir soru sorar. Kredi 24 aydan uzun mu? Sola ya da sağa git. Sonra bir soru daha, bir daha, ta ki bir yaprak cevabı verene kadar. İnsanların ağaçlara güvenmesinin sebebi bu: kökten yaprağa giden yol kararın gerekçesidir ve ilgili kişiye yüksek sesle okunabilir. Ağaçların zayıf olmasının sebebi de aynı. Her soruda tek özellik demek, her sınırın bir eksen boyunca bir basamak olması demek; çapraz bir çizgiyle ayrılan iki sınıfa oturmak için onlarca basamaklı bir merdiven gerekiyor.
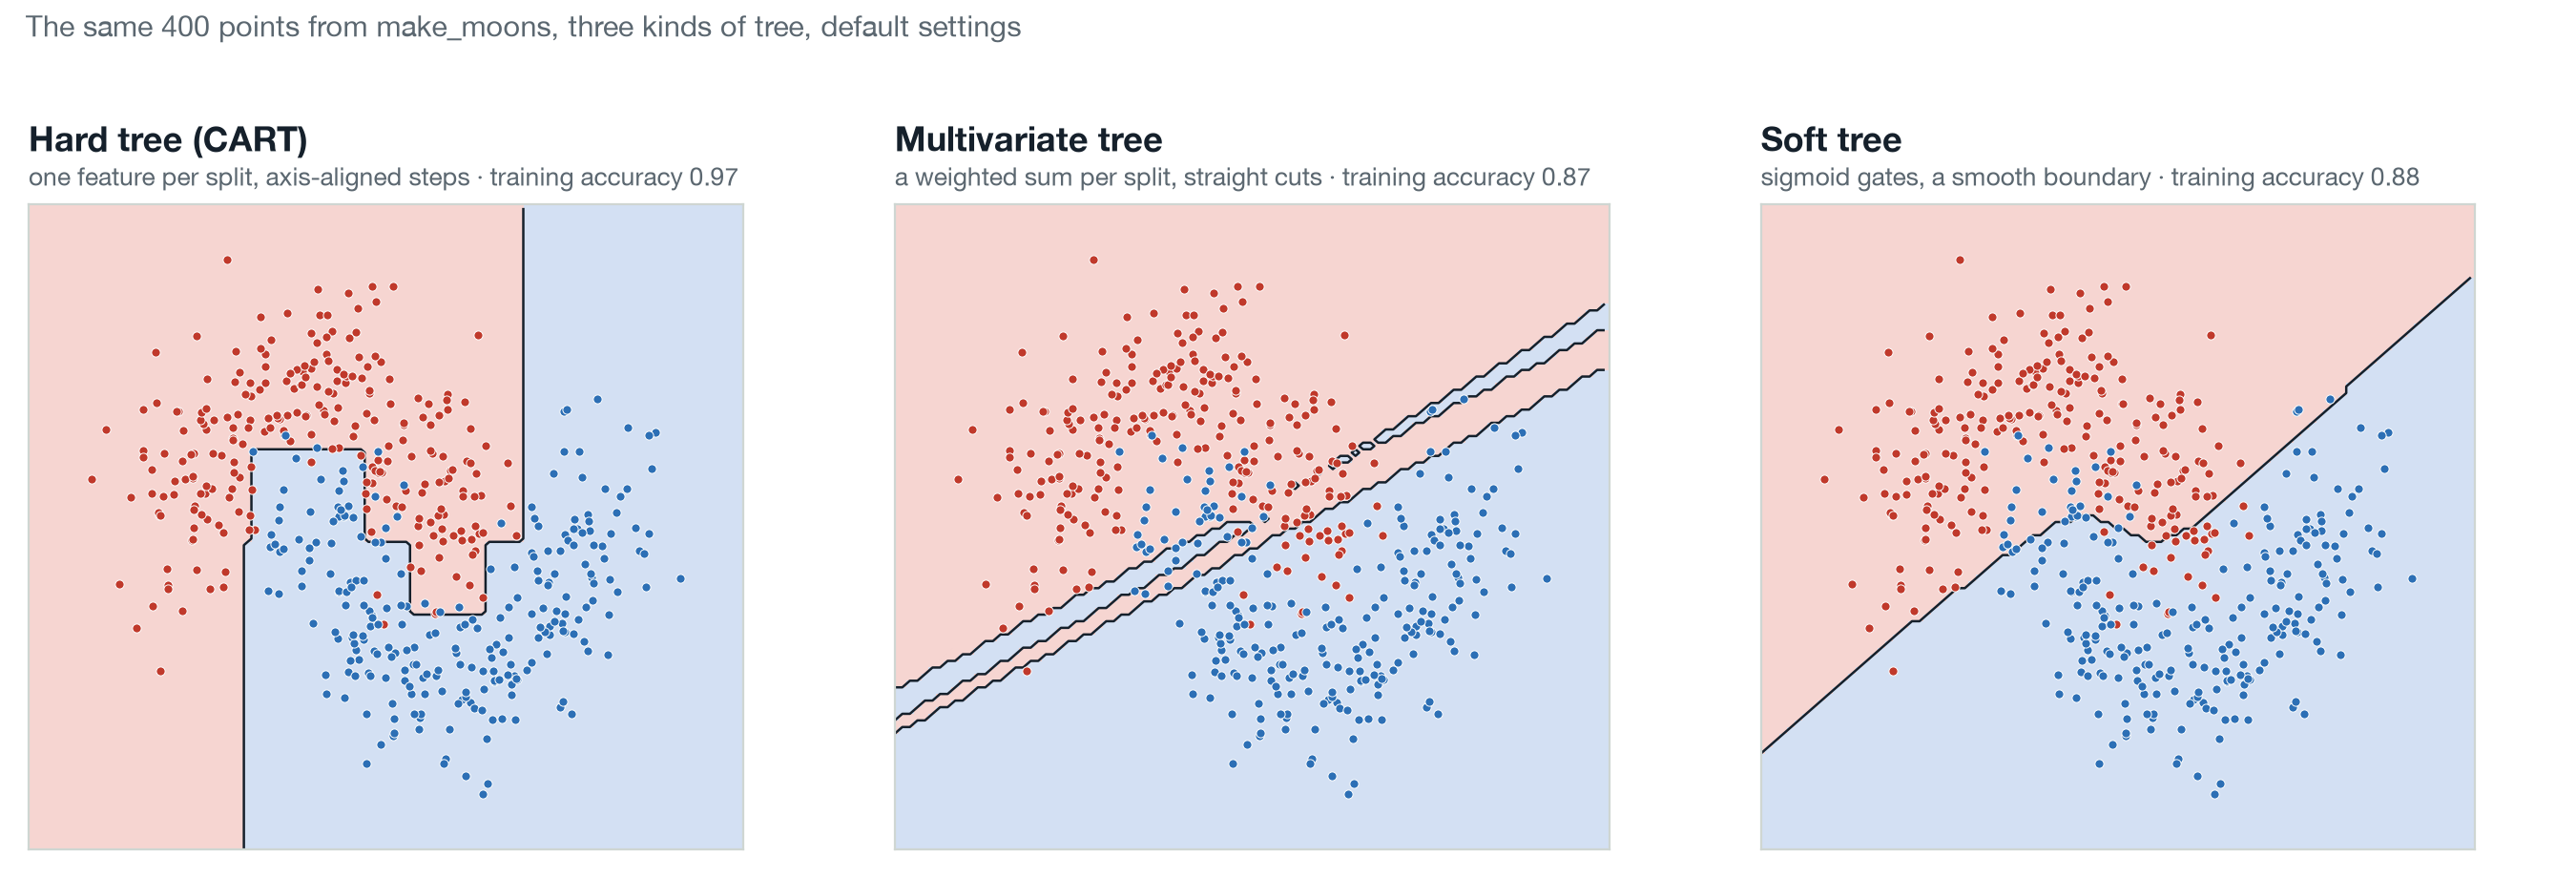
Şekil 1'in sol paneli o merdiven. Ortadaki panel çok değişkenli ağaç: her soru özelliklerin ağırlıklı bir toplamı üzerine, dolayısıyla bir kesim herhangi bir açıda düz bir çizgi olabiliyor ve merdivenin bir düzine basamakla yaptığını iki kesim yapıyor. Sağdaki panel yumuşak ağaç ve bir şeyi daha değiştiriyor. Her kapıda nokta sola ya da sağa gönderilmiyor. Bir payı bir tarafa, kalanı öbür tarafa gidiyor; pay, ağırlıklı toplamın sigmoidi. Aynısı bir sonraki kapıda da oluyor, yani her nokta her yoldan oranıyla akıyor ve tahmin bütün yaprakların karışımı. Bunların hepsi türevlenebilir olduğu için ağacın tamamı gradyan inişiyle, bir sinir ağı nasıl eğitiliyorsa öyle eğitiliyor. İsimdeki "neural" bu ve sınırın pürüzsüz çıkmasının sebebi de bu.
Eğitim doğrulukları panellerin üstünde yazıyor ve merdiven kazanıyor: 0.88'e karşı 0.97. Eğitim doğruluğu ezberleyen modeli ödüllendirir; yazıdaki şüpheyle okunması gereken ilk sayı bu. Asıl kıyaslamalar ileride, modellerin hiç görmediği veride.
Adım 2. Kutuda Ne Var
Beş model, tek bir scikit-learn arayüzü (fit, predict, predict_proba, sınıf ve örnek ağırlıkları) ve bir regresör. Birine gösterecek olsam şu sırayla:
- SoftDecisionTree. Sağ paneldeki model; İrsoy, Yıldız ve Alpaydın'dan. Ya bir derinlik verirsiniz ya da her seferinde bir yaprak büyümesini ve ayrılmış bir doğrulama parçası "dur" deyince durmasını söylersiniz. Regresyon sürümü de var.
- MultivariateDecisionTree. Ortadaki panel: düz kesimler, sert kararlar, okunabilir ağırlıklar.
- OmnivariateDecisionTree, Yıldız ve Alpaydın'dan. Her düğümde tek özellikli, doğrusal ve doğrusal olmayan bölünme arasında istatistiksel bir testle seçim yapıyor; ağaç yalnızca o düğümdeki verinin gerektirdiği kadar karmaşık oluyor.
- HierarchicalMixtureOfExperts, Jordan ve Jacobs'tan. Yaprakları sabit değil küçük birer model olan bir yumuşak ağaç.
- GALNetwork, Alpaydın'dan. Hata yapınca bir birim ekleyen, artık ihtiyaç duymadığı birimleri çıkaran, yani kendi boyutuna kendisi karar veren bir ağ.
Yanlarında birleşik 5x2cv F testi var, o da Alpaydın'ın; çünkü iki modelin tek bir eğitim-test bölünmesindeki farkı çoğunlukla gürültüdür ve bunu kullanıcıya bırakmak yerine kütüphanenin söylemesini istedim.
Adım 3. Ayları Alan Kısım
Modellerin dördü ilk yazıldığında çalışmıyordu; "yavaştı" demiyorum, çalışmıyordu. Uzman karışımı tek bir gradyan adımı atamıyordu. Omnivariate ağaç her girdi için aynı yaprağı döndürüyordu. GAL, düz bir çizgiyle ayrılan veride yazı tura seviyesindeydi. Her biri teşhis edildi, düzeltildi ve eski koda karşı düşen bir regresyon testi aldı; hata sessizce geri dönemez.
Bir de makalelerin açık bıraktığı, kütüphanenin vermek zorunda olduğu kararlar var. İlk anlatacağım, bir yumuşak ağacın nasıl büyümesi gerektiği. Bir ağacı derinleştirmenin doğal yolu bir yaprağı iki çocuğa bölmek ve ikisine de ebeveynin dağılımını vermek; böylece bölünme anında hiçbir şey değişmiyor ve eğitim devam ediyor. Ben de öyle yaptım ve yeni kapı hiçbir şey öğrenmedi. Sebep gradyanının küçük olması değil. İki çocuk tam olarak aynı şeyi tahmin ederken aralarında seçim yapan kapının gradyanı tam olarak sıfır; ilerleyeceği bir yön yok. Düzeltme tek satır: iki çocuğu artıktan, yani ebeveynin yanlış yaptığı kısımdan, zıt yönlere itilmiş olarak başlat. İspat ve ölçümler kütüphaneye eşlik eden makalede; aynı kusur yaprak yaprak büyümede de ortaya çıktı ve orada da düzeltildi.
Diğerleri aynı yolla karara bağlandı: alternatifler kıyaslama veri kümelerinde çalıştırıldı, kazanan kaldı. Büyüme sabit bir eşikte değil, ayrılmış verideki hatada duruyor; yeni GAL birimleri artıktan başlıyor; yumuşak kapılarda bir sıcaklık parametresi var ama varsayılan olarak kapalı, çünkü ölçülen etkisi karışıktı. Bunların her birinin belgeleme sitesinde bir tablosu var ve işe yaramayan alternatifler silinmedi, işe yaramadı diye yazıldı.
Adım 4. Modeli Geri Okumak
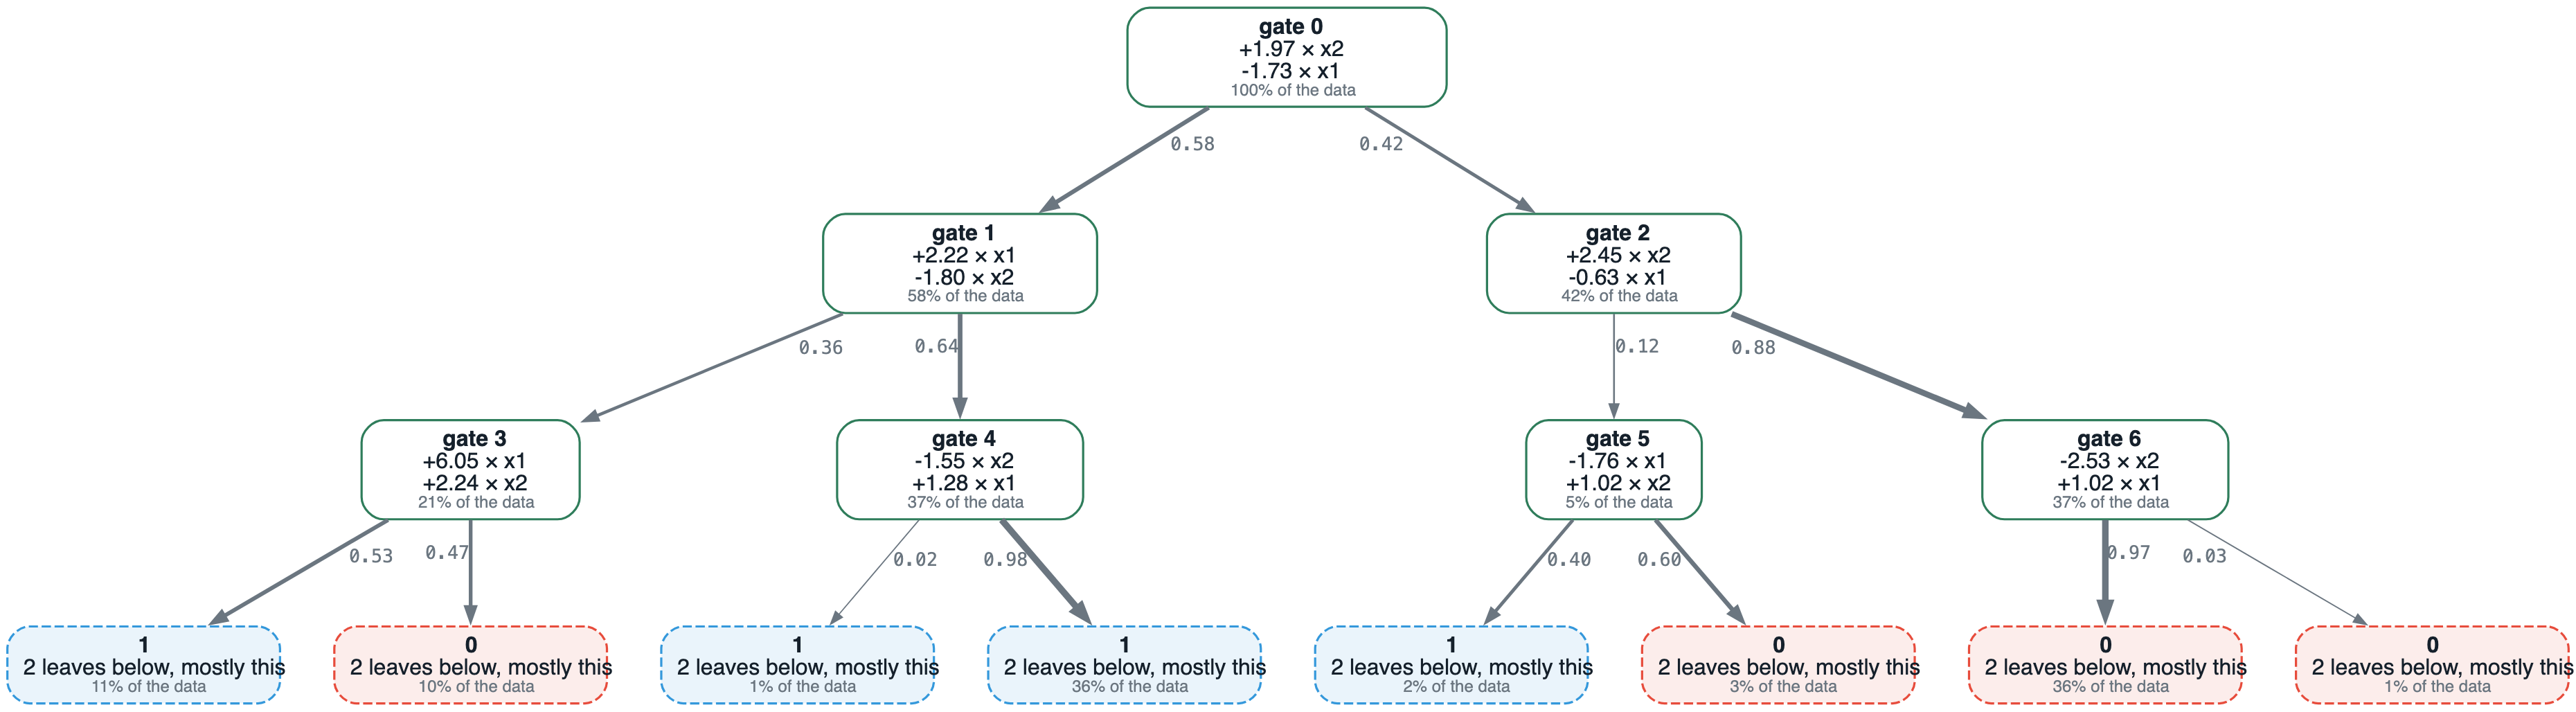
Şekil 2, Şekil 1'deki ağacın gerçekte ne olduğu ve küçük: yedi kapı, sekiz yaprak, her birinde iki ağırlık. Playground her model ve her veri kümesi için bu çizimi gösteriyor. Tek bir tahmin için explain() aynı yapıda yürüyor ve şu sırayla raporluyor:
- tahmin edilen sınıf ve olasılığı;
- o satırın çoğunu alan yaprak ve ne kadarını aldığı;
- o yaprağa giden yoldaki her kapı: alınan yön, o yönün olasılığı ve kararı belirleyen iki üç özellik;
- tahmin edilen sınıfı çeviren en küçük tek özellik değişikliği. Kütüphane bunu tahmin etmiyor. Özelliği oynatıyor, yeniden tahmin ediyor ve değişikliği yalnızca sınıf gerçekten değişirse raporluyor; o yolda hiçbir tek değişiklik çevirmiyorsa öyle diyor.
Bununla gelen iki dışa aktarma var. Eğitilmiş ağaç sert kurallar olarak okunabiliyor, her kapı bir evet-hayır kararı sayılarak; bu farklı bir model ve öyle raporlanıyor: kütüphane kuralların geldikleri ağaçla ne sıklıkla uyuştuğunu varsaymıyor, ölçüyor. Ağaç ayrıca yalnızca numpy ile tahmin yapan bir JSON dosyasına ve ONNX'e yazılabiliyor; ONNX'te tek satırın tahmini tek bir işlemci çekirdeğinde yaklaşık 11 mikrosaniye sürüyor ve ne torch'a ne kütüphaneye ihtiyaç duyuyor. Aynı makinede torch modeli 91 mikrosaniye.
Adım 5. Nerede Kazanıyor, Nerede Kaybediyor
Dokuz model, 24 veri kümesi (alışılmış scikit-learn kümeleri ve OpenML'den yirmi tane, 5.000 satırla sınırlı), üç tohumla beş katlı çapraz doğrulama ve hiçbir şey ayarlanmadan: her model her yerde tek bir sabit yapılandırmada; yumuşak modeller de XGBoost, LightGBM, GRANDE ve NODE da.
24'ünün toplamında boosting toplulukları, Random Forest ve düz bir MLP önde, yumuşak modeller bir iki puan geride. Veri kümelerini boyuta göre ayırınca sıra tersine dönüyor. En fazla 1.000 satırı olan sekiz kümede GAL ayarlanmamış XGBoost'u hepsinde geçiyor, ortalama 2.9 puanla; yaprak yaprak büyüyen yumuşak ağaç sekizin yedisinde geçiyor, 2.1 puanla. 1.000 satırın üstünde XGBoost neredeyse her kıyaslamayı kazanıyor.
Üç uyarı, çünkü alıntılanacak paragraf yukarıdaki. 1.000 satırlık bölme noktası veriyi gördükten sonra seçildi. MLP de küçük kümelerde kazanıyor, yani bulgu şu: gradyan inişiyle eğitilen pürüzsüz modeller küçük tablolarda ayarlanmamış boosting'i geçiyor; yumuşak ağacın eklediği şey okunabilmesi. Ve o cümledeki "ayarlanmamış" kelimesi gerçekten iş görüyor; ayarlanmış bir LightGBM farkın bir kısmını kapatır, ne kadarını ölçmedim.
Kural kısa. Binlerce satırınız varsa ve tek derdiniz doğruluksa LightGBM kullanın.
Adım 6. Her Kararın Açıklanmak Zorunda Olduğu Bir Tablo
Kütüphaneyi yazma sebebim öbür durum, o yüzden onu herkese açık German Credit verisinde baştan sona çalıştırdım: 1.000 kredi başvurusu, 20 özellik, 700'ü geri ödemiş, 300'ü ödememiş. Veri kümesiyle birlikte bir maliyet matrisi geliyor. Sonradan kötü çıkan bir başvuranı kabul etmek 5'e, iyi çıkacak birini reddetmek 1'e mal oluyor. Bunu sonuna kadar götürün: beklenen maliyeti en aza indiren karar "P(kötü) yarımın üstündeyse reddet" değil, "P(kötü) altıda birin üstündeyse reddet"; çünkü kaçırılan bir kötü başvuru, reddedilen bir iyi başvurunun beş katına mal oluyor. Aşağıdaki her şey o eşikte ölçüldü.
Her model için aynı katlar, üç tohumla beş kat, hiçbir şey ayarlanmadan, altıda bir eşiğinde başvuru başına maliyet:
| Model | Doğruluk | AUC | Başvuru başına maliyet |
|---|---|---|---|
| Yumuşak ağaç, yaprak yaprak büyüyen | 0.747 | 0.786 | 0.548 |
| Lojistik regresyon | 0.747 | 0.787 | 0.536 |
| Random forest | 0.763 | 0.794 | 0.544 |
| XGBoost | 0.749 | 0.775 | 0.625 |
| LightGBM | 0.746 | 0.775 | 0.710 |
Yumuşak ağaç ile lojistik regresyon, ki bir kredi skor kartının altında yatan şey odur, bu veride birbirinden ayırt edilemiyor. Random forest 1.6 puan daha doğru ve daha ucuz değil; oraya varmak için başvuranların %71'ini reddediyor, yumuşak ağaç %59'unu. İki boosting modeli doğrulukta herkese yetişiyor, maliyette kaybediyor ve sebebi takip etmeye değer, çünkü kalibrasyon lehine bütün argüman bu. Boosting olasılıklarını 0'a ve 1'e doğru itiyor. Bu veride LightGBM 1.000 başvurunun 604'ünü 0.1'in altına koydu ve onların %16'sı kötü çıktı; yumuşak ağacın olasılıkları gözlenen oranı aralık aralık izliyor, beklenen kalibrasyon hatası LightGBM'in 0.16'sına karşı 0.03. Eşik yarımken bu pek fark etmiyor. İş kararının verildiği altıda birde ise iki maliyet sütunu arasındaki fark tam olarak bu.
Yumuşak ağacın skor kartına eklediği şey, 3. ve 4. adımların sebebi. Son modelde iki yumuşak bölünme ve üç yaprak var; sert kural olarak okununca ayrılmış başvuruların %92'sinde modelle uyuşuyor. Her başvuru için yol var ve gerçek bir insanın uygulayabileceği bir karşı örnek var. Tam eşikte duran başvuran için meslek kategorisini "vasıflı"dan "vasıfsız, yerleşik"e çevirmek kararı eşiğin öbür tarafına geçiriyor ve rapor bunu standartlaştırılmış birimlerle değil tablonun kendi kelimeleriyle söylüyor. Rapor kararları yaşa, cinsiyete ve yerleşikliğe göre de diliyor, çünkü bir denetçi dileyecek: 25 yaş altı başvuranlar %77 oranında reddediliyor, geri kalanlar %56; aynısı lojistik regresyonda da var, yani mesele model değil veri. Kat kat sayılardan model belgesine kadar her şey tek bir betikten yeniden üretiliyor: cases/german-credit.
Kimin İçin
Üç durum var ve cevap her birinde farklı.
Binlerce satırınız var ve doğrulukla ölçülüyorsunuz. Bu değil. LightGBM kullanın; biri neden diye sorarsa 5. adımdaki sayıları gösterin.
Birkaç yüz ile birkaç bin arasında satırınız var ve her karar birine açıklanmak zorunda: bir kredi reddi, bir klinik uyarı, bir denetim bulgusu. Kütüphane bunun için ve uyup uymadığını anlamaya on dakika yetiyor. Kendi CSV ya da Excel dosyanızı neural-trees.streamlit.app adresindeki playground'a yükleyin; 6. adımdaki kıyaslamayı sizin tablonuzda çalıştırıyor, kuralları ve açıklamaları gösteriyor, JSON ve ONNX dosyalarını veriyor. Yüklediğiniz hiçbir şey saklanmıyor.
Bu modelleri öğretiyor ya da çalışıyorsunuz. Her biri tek bir import uzağınızda; geldiği makale docstring'de yazıyor, uygulamanın makaleden ayrıldığı yerler sayılarıyla not edilmiş.
- Kod: github.com/cgrtml/neural-trees
- Kurulum:
pip install neural-trees - Belgeler: cagritemel.com/neural-trees
- Arşivlenmiş sürüm: doi.org/10.5281/zenodo.22718897
İkinci türden bir tablonuz varsa German Credit paketini onun üzerinde çalıştırırım, ücretsiz, iki hafta içinde; yukarıda bağlantısı verilen rapor tam olarak elinize geçecek şey. Issue ve pull request'e açığım; şimdiye kadar açılanların hepsi ölçülmüş bir raporla geldi, öyle kalmasını isterim.